データの正規性とパラメトリック解析・ノンパラメトリック解析
 アカデミックラウンジ
統計解析するにあたって、データ分布を知ることはとても重要です。手持ちのデータが特定の分布傾向を示すのであれば、母集団もその分布に従うと仮定して解析でき、このような解析をパラメトリックな解析と言います。
逆に手持ちのデータが特定の分布傾向を示さない場合は、母集団の分布も分からないため、データ分布を仮定しない解析を行う必要があります。このような解析をノンパラメトリックな解析と言います。
そして、データの分布として最もよく使われるのが正規分布です。グループ間を比較するにしても変量間の関連を調べるにしても、データが正規分布しているかどうかは重要なチェックポイントなので、今回はデータの正規性について解説したいと思います。
正規分布とは?
正規分布とは、ヒストグラム(度数分布図)を描いたときに、多くのデータが平均値近くにあり、平均値から離れるほどデータの数が少なくなっていくような分布です(図1)。左右対称の山型の分布と言えます。度数のピークが分布の右側や左側に寄っている場合(左右対称でない場合)は、正規分布とは言えません。


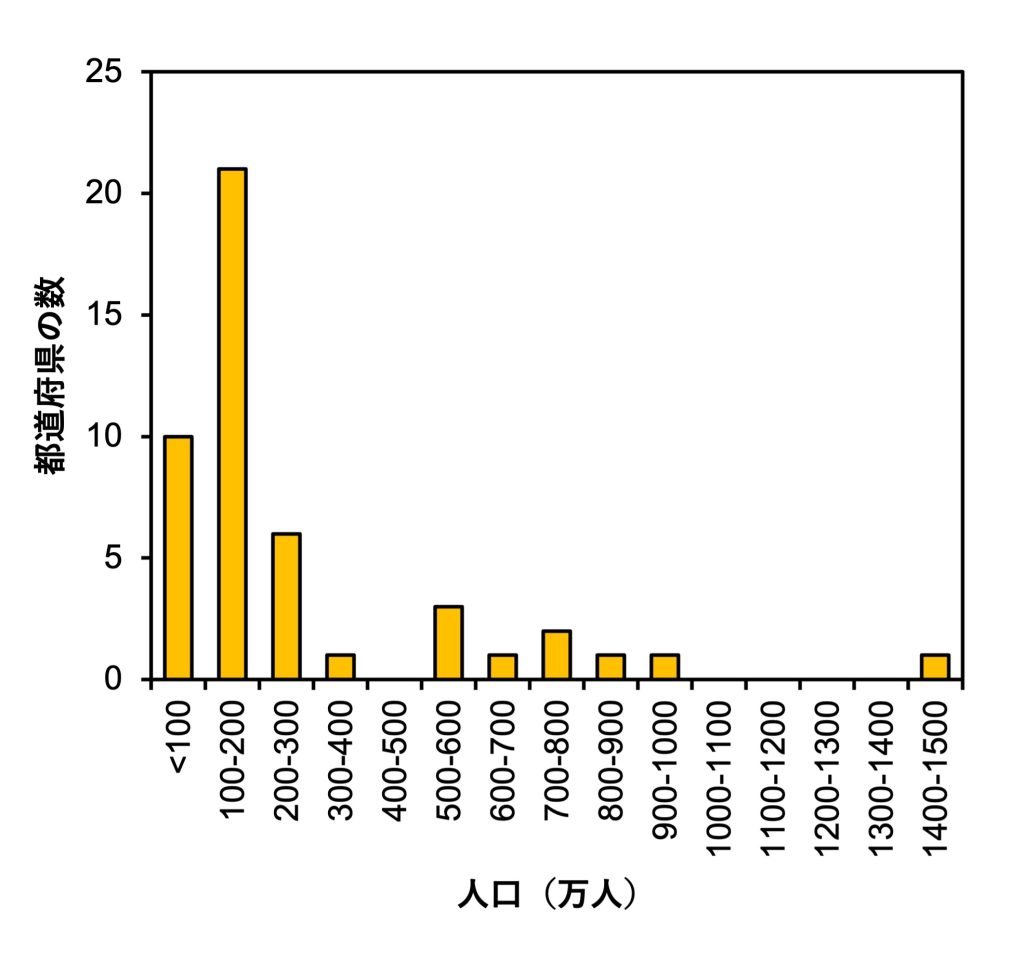
正規分布を示す例としては、身長や睡眠時間(図2)などが挙げられます。データ分布のほぼ中央にピークがあり、左右対称の分布となっています。一方、図3は都道府県別の人口分布ですが、多くの県に比べて極端に大きな値(東京都や大阪府など)があり、このような分布は正規分布とは言えません。
正規性を確認する方法
データが正規分布しているかどうか確認するには、次のような方法があります。
(1)シャピロ・ウィルク(Shapiro-Wilk)検定
(2)コルゴモロフ・スミルノフ(Kolmogorov-Smirnov)検定
(3)アンダーソン・ダーリン(Anderson-Darling)検定
(4)Q-Qプロットやヒストグラムで視覚的に確認
ただし、(1)から(3)はあくまで正規分布かどうかを判定するための検定で、パラメトリックな解析をするかノンパラメトリックな解析をするかを判定するためのものではありません。本記事の冒頭で、データが正規分布しているかどうかは、パラメトリックな解析をするかノンパラメトリックな解析をするか判断するための重要なポイントと書きましたが、(1)~(3)のような正規性検定を結果をもって、パラメトリックな解析をするかノンパラメトリックな解析をするか判断するわけではないということです(検定の多重性の問題が生じます)。
パラメトリックかノンパラメトリックかを判断するには、検定ではなく、(4)の方法で視覚的に正規分布かどうかを確認します。
データの正規性が仮定できる場合は、パラメトリックな解析を行うことができます。パラメトリックな解析には、例えば回帰分析や分散分析、t検定などがありますが、これらを行う場合、「データの正規性」とは正確には「残差の正規性」であることに注意しましょう。
データ変換
データの正規性が確認できない場合、ノンパラメトリックな解析を検討することになりますが、すぐにノンパラメトリックな解析に進むのではなく、対数変換や平方根変換などでデータを変換してみます。例えば「10」という観測データであれば、ln10(=2.30)を計算します。そうやって変換したデータを使ってもう一度正規性を確認し、おおむね正規分布であることが確認できれば、対数変換したデータを使ってパラメトリックな解析を行っていきます。
対数変換のほかにも、平方根変換や逆数変換など、様々な方法でデータを変換することもできます。データの分布特性に応じて、適切な変換方法を考えましょう。
ノンパラメトリックな解析
データを変換しても正規性が確認できない場合は、ノンパラメトリックな解析を使うことになります。ノンパラメトリックな解析の多くは、データを順位に変換して計算するため(1番高かった値、2番目に高かった値・・・)ので、データ分布の正規性を気にする必要がありません(ただし、データ分布の広がり、つまり等分散性の条件は、ノンパラメトリックな解析でも必要になることがあります)。
ノンパラメトリックな解析には、例えばマン・ホイットニー(Mann–Whitney)のU検定やクラスカル・ウォリス(Kruskal–Wallis)検定、スピアマン(Spearman)の順位相関係数などがあります。
まとめ
今回の記事では、データの正規性について簡単に紹介しました。論文を書くときにデータの正規性に注目するのは、ほとんどの場合、正規分布しているかどうかというより、パラメトリックな解析をするかノンパラメトリックな解析をするかを判断するためだと思います。その場合は、正規性の検定を行うのではなく、データ分布を視覚的に確認すれば済むということを覚えておきましょう。
また、今回の記事では詳細に触れませんでしたが、回帰分析や分散分析、t検定などで求められるのはデータそのものの正規性ではなく、残差の正規性であることにも注意する必要があります。この点については別記事でまとめたいと思います。
<参考文献>
井口豊(2023)「正規性検定をノンパラメトリック検定の選択基準にするな」
井口豊(2026)「等分散検定からt検定,ウェルチ検定,U検定への問題点」
データ分析 相談サービス
統計解析や質的研究(KJ法、M-GTA、TEAなど)の方法を研究者がオンラインで解説しています。代行ではなく、分析方法を学びたい方向けの個別指導講座です。テキストマイニ…
 アカデミックラウンジ


この記事を書いた人
田中泰章
Yasuaki Tanaka
プロフィール
自然の仕組みや環境問題、社会・教育制度などについて広い視点から考える自然科学者。2008年に東京大学大学院で博士号(環境学)を取得した後、東京大学、琉球大学、米国オハイオ州立大学、ブルネイ大学など、国内外の大学で研究と教育に約15年間携わってきました。これまでに40本以上の論文を出版し、国際的な科学雑誌の査読者として多数の論文審査も行っています。大学教員としては、これまでに40名以上の学生(学部・修士・博士を含む)を研究指導し、若手研究者を育成してきました。専門は「人間と自然とのかかわり」で、人間活動が自然界に与える影響を生物学・化学・社会学などの複合的な視点から研究しています。
アカデミックラウンジ
サービス案内